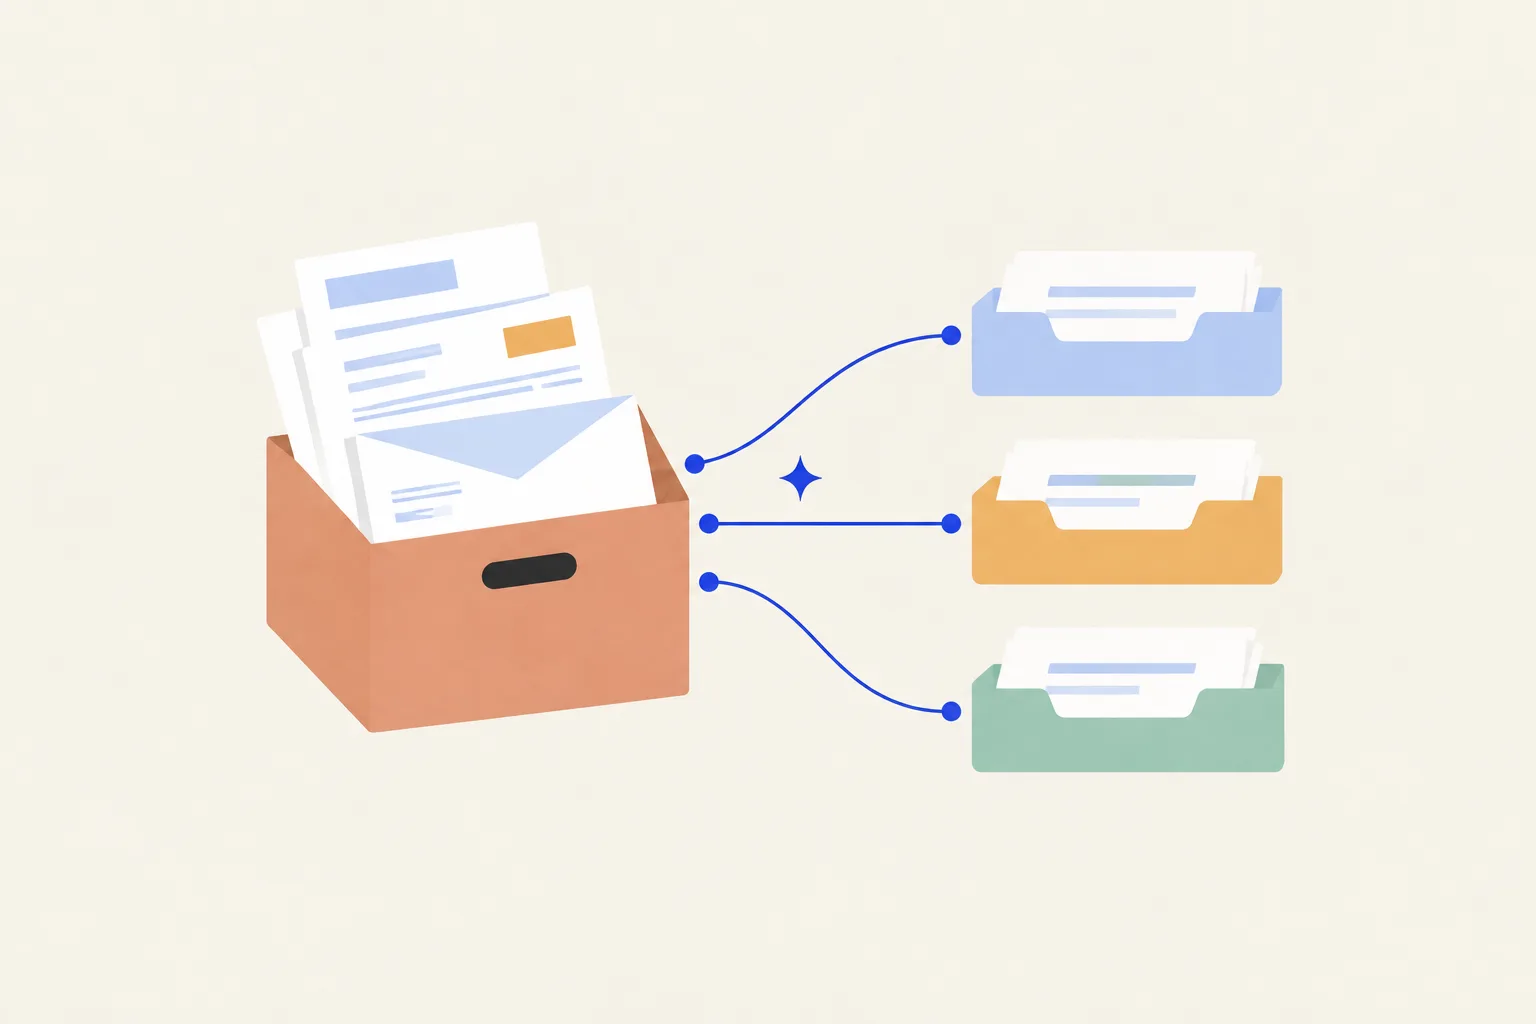
Sim, a IA consegue fazer a primeira triagem de muitos pedidos de uma PME: dizer se um email é uma reclamação, se uma fatura traz os campos de que a contabilidade precisa, se um pedido é urgente ou se falta algum documento a um fornecedor. A triagem com IA funciona melhor quando a pergunta é fechada (sim, não, ou uma categoria de uma lista curta), quando a resposta vem num formato fixo e quando existe sempre a saída “não sei”, que manda o caso para uma pessoa. Para isto chega um modelo pequeno: num exemplo ilustrativo de 5000 classificações por mês, a conta fica entre menos de 1 € e cerca de 18 €, consoante o modelo. O que não deve fazer é usar este sim ou não para decidir sobre pessoas.
Este artigo explica a ideia sem programação. Para a montar, veja o guia de automação com n8n; mais conteúdos sobre documentos e papelada na área Administrativo.
Porque é que tantas automações começam com uma pergunta de sim ou não?
Olhe para a caixa de email geral de uma empresa de 10 pessoas. Antes de alguém responder, há uma decisão silenciosa: isto é para quem? É urgente? Pode esperar? A mesma decisão aparece noutros sítios:
- Emails de clientes: é reclamação, pedido de orçamento, pedido de informação ou publicidade?
- Faturas de fornecedores: tem NIF, data, número, base, IVA e total? Ou falta alguma coisa?
- Pedidos internos: este pedido de compra está abaixo do valor que o chefe de equipa aprova sozinho?
- Documentos de fornecedores: a declaração de não dívida e o seguro estão dentro do prazo, ou falta algum?
Nenhuma destas tarefas exige criatividade, só atenção, e por isso cansam e falham ao fim do dia. A IA não substitui quem responde ao cliente ou paga a fatura; faz a separação inicial, para que cada pessoa receba só o que é seu, e com uma etiqueta.
Como é que um modelo de linguagem classifica pedidos?
Um modelo de linguagem como o GPT, o Claude ou o Gemini foi feito para escrever texto. Para classificar pedidos com IA, pede-se-lhe que escreva pouco: só a resposta, num formato que um programa consiga ler. Esse formato chama-se JSON, uma forma de escrever dados que as ferramentas de automação leem sem esforço. Por exemplo:
{
  "categoria": "reclamacao",
  "urgente": true,
  "motivo": "Cliente diz que a encomenda chegou partida e pede devolução."
}
Durante muito tempo, pedia-se isto no prompt (a instrução que se dá à IA), “responde só em JSON”, e o modelo às vezes inventava uma categoria ou esquecia um campo, e a automação parava. Hoje os três grandes fornecedores têm uma função própria para isso, a que chamam saídas estruturadas (structured outputs):
| Fornecedor | Como se chama | O que garante, segundo a documentação |
|---|---|---|
| OpenAI | Structured Outputs | A resposta segue sempre o esquema dado; o modelo não omite campos obrigatórios nem inventa valores fora da lista |
| Anthropic (Claude) | Structured outputs: JSON outputs ou uso estrito de ferramentas (strict tool use) | Resposta sempre válida e com os campos e tipos certos; nos valores de lista, as maiúsculas podem variar |
| Google (Gemini API) | Structured output, com um esquema JSON no pedido | JSON sintaticamente válido, de acordo com o esquema; a Google recomenda validar os valores na mesma |
O esquema é a “ficha” que o modelo tem de preencher: que campos existem, de que tipo são, e, no caso das categorias, a lista fechada de valores possíveis. É essa lista fechada que transforma um modelo que escreve num modelo que escolhe.
Duas notas práticas. A forma está garantida, o conteúdo não: o JSON vem sempre certo, mas o modelo pode pôr na gaveta errada uma reclamação disfarçada de pedido de informação. E há casos em que o esquema não é respeitado, por exemplo quando o modelo recusa responder por razões de segurança ou quando a resposta é cortada por exceder o limite de tamanho; a automação deve tratar esses casos como “não sei”.
Que modelo usar e quanto custa?
Para uma triagem com três a dez categorias, os modelos mais baratos de cada fornecedor costumam chegar. Os modelos de topo são feitos para raciocínios longos e documentos difíceis, e numa pergunta fechada pagam-se sem necessidade.
Os preços por API (a ligação técnica que permite a um programa usar o modelo) cobram-se por tokens, pedaços de texto um pouco mais pequenos do que uma palavra, separando o texto que entra do que sai. A lista completa está em novos modelos de IA de setembro de 2026; no exemplo de contas mais abaixo usamos os mesmos valores. Se quiser que seja o sistema a escolher, pedido a pedido, entre um modelo barato e um caro, veja routers de modelos de IA.
Modelos de decisão: uma categoria nova
Em setembro de 2026 apareceram na OpenRouter (um serviço que dá acesso a modelos de vários fornecedores com uma só conta) os primeiros “modelos de decisão”. Não escrevem texto: recebem o pedido e uma pergunta com as opções possíveis e devolvem a escolha com uma probabilidade associada, calculada pelo próprio modelo. Verificámos dois nas páginas oficiais da OpenRouter:
- Jev 1.13, da TypeSafe (lançado a 18 de setembro de 2026): cerca de 0,04 € por milhão de tokens de entrada, saída gratuita. Responde a três tipos de pergunta: escolha entre opções, sim ou não, e posição numa escala. Só aceita texto (não lê PDF nem imagens) e lê até cerca de 32 000 tokens de cada vez.
- Solar Decide, da Upstage (lançado a 28 de setembro de 2026): cerca de 0,04 € por milhão de tokens de entrada, com um desconto de 50% por tempo limitado (cerca de 0,09 € sem desconto), saída gratuita. Aceita documentos muito maiores, mas a Upstage destaca a compreensão de coreano e o tempo de resposta mediano listado era de vários segundos.
Antes de os usar, três cautelas. Funcionam numa interface da OpenRouter ainda em fase alfa, ou seja, sujeita a mudanças. A própria OpenRouter avisa que o Jev perde precisão quando o pedido traz muita informação irrelevante e que não é fiável a fazer contas, contar ou comparar datas, o que exclui perguntas como “a fatura está vencida?”. E não encontrámos informação sobre o desempenho em português nem sobre onde são tratados os dados; se o pedido tiver dados pessoais, confirme isso primeiro.
Exemplo de contas: 5000 classificações por mês
Exemplo ilustrativo: uma distribuidora recebe cerca de 5000 emails por mês na caixa geral e quer separá-los em cinco categorias, com uma marca de urgência. Cada pedido leva o email e as instruções, cerca de 800 tokens; a resposta tem cerca de 50 tokens. Ao todo, 4 milhões de tokens de entrada e 0,25 milhões de saída. Estes números são hipóteses para dar a ordem de grandeza, não medições.
| Modelo | Conta | Custo por mês, sem IVA |
|---|---|---|
| GPT-6 Luna | 4 × 0,09 € + 0,25 × 0,44 € | cerca de 0,50 € |
| Gemini 3.8 Flash (até dezembro) | 4 × 0,66 € + 0,25 × 3,30 € | cerca de 3,50 € |
| Claude Haiku 4.5 | 4 × 0,88 € + 0,25 × 4,40 € | cerca de 4,60 € |
| Claude Sonnet 5.5 | 4 × 1,76 € + 0,25 × 8,81 € | cerca de 9 € |
| Claude Opus 5.5 | 4 × 3,52 € + 0,25 × 17,61 € | cerca de 18,50 € |
| Jev 1.13 | 4 × 0,04 € | cerca de 0,15 € |
Preços por milhão de tokens (entrada e saída), sem IVA. O do Gemini 3.8 Flash duplica a partir de 1 de janeiro de 2027.
Em todos os casos, a fatura da IA é pequena ao lado do tempo de quem hoje faz a separação à mão. A escolha do modelo decide-se pela taxa de erro no seu teste, não pelo preço. Se a triagem não tiver pressa (por exemplo, arrumar um arquivo de emails antigos), o processamento em lote corta o preço para metade, como explicamos em IA em lote: como pagar metade. Para comparar as horas poupadas com o custo de montagem, use a calculadora de poupança com automação.
A opção “não sei” e a confiança
O erro mais comum numa triagem com IA é obrigar o modelo a escolher. Se as únicas opções forem “sim” e “não”, um caso ambíguo vai cair num dos lados, e ninguém dá por isso. Por isso:
- Inclua sempre uma categoria “não sei” ou “outro” na lista fechada, e diga no prompt quando a usar: “se o email não encaixar claramente numa categoria, ou se faltar informação, escolha não sei”.
- Peça um campo de motivo curto. Uma frase que explique a escolha ajuda quem revê a perceber o erro em segundos.
- Desconfie da “confiança” escrita pelo modelo. Se pedir a um modelo de linguagem que escreva um número de 0 a 100 sobre a sua própria certeza, esse número é texto, não uma medição. Teste se os casos com “confiança alta” erram mesmo menos. Os modelos de decisão como o Jev devolvem uma probabilidade calculada pelo modelo, que também se verifica com os seus dados.
- Separe o que é regra do que é interpretação. Se o NIF tem 9 dígitos, se o total é a soma da base com o IVA, se a data está dentro do prazo: isto verifica-se com uma regra simples na automação, sem IA. A IA fica com o que precisa de leitura, como “este email é uma reclamação?”.
No n8n, o nó Text Classifier já traz esta lógica: define as categorias com uma descrição de cada uma e, na opção “When No Clear Match”, escolhe enviar os casos sem correspondência para um ramo “Other”, em vez de os descartar.
Quem revê o quê
Uma boa regra para começar: o que a IA aprova segue, o que rejeita ou não sabe vai para uma pessoa. Uma fatura completa entra na fila de lançamento; uma fatura a que “falta o NIF” vai para alguém confirmar antes de se pedir uma nova ao fornecedor. Um email marcado como publicidade vai para uma pasta que alguém percorre uma vez por semana, não para o lixo.
Um falso “não” custa mais do que parece: uma reclamação arquivada como publicidade é um cliente que não volta. Com números do seu teste, pode depois alargar o que segue sem revisão.
Como testar em 100 exemplos reais
Antes de ligar a triagem ao email ou à pasta de faturas:
- Junte 100 casos reais do último mês, com uma mistura parecida com a do dia a dia. Inclua os difíceis.
- Classifique-os à mão, com a pessoa que hoje faz esse trabalho. Esta é a resposta certa.
- Corra os mesmos 100 casos no modelo e ponha as duas respostas lado a lado numa folha de cálculo.
- Conte três números: quantos acertou, quantos foram para “não sei” e, dos errados, quantos são graves (uma reclamação tratada como publicidade é grave; um pedido de informação tratado como pedido de orçamento, menos).
- Ajuste e repita. Na maior parte das vezes o problema não é o modelo, é a descrição da categoria: duas categorias que se sobrepõem, ou uma regra que só estava na cabeça de quem faz o trabalho.
Não há um número mágico: defina antes do teste quantos erros graves aceita e quantos “não sei” a equipa consegue rever por dia. Se o resultado ficar aquém, experimente um modelo acima antes de desistir. Depois de ligada, reveja uma amostra todos os meses: os emails mudam, os fornecedores mudam, e o modelo pode ser atualizado pelo fabricante.
Decisões sobre pessoas: aqui não
Tudo o que está acima vale para emails, faturas, encomendas e documentos. Não vale para decisões sobre pessoas: aceitar ou rejeitar um candidato, aprovar crédito a um cliente particular, decidir quem é promovido.
O artigo 22.º do RGPD (Regulamento (UE) 2016/679) dá a cada pessoa o direito de não ficar sujeita a uma decisão tomada só por meios automatizados que produza efeitos jurídicos ou a afete de forma significativa. E o AI Act (Regulamento (UE) 2024/1689) classifica como alto risco, no anexo III, a IA usada para recrutar e gerir trabalhadores ou para avaliar a capacidade de crédito de particulares. Segundo a Comissão Europeia, as regras para estes sistemas aplicam-se a partir de 2 de dezembro de 2027, mas o artigo 22.º do RGPD já se aplica hoje.
Na prática, nestes casos a IA pode, no máximo, organizar a informação para que uma pessoa decida, e essa pessoa tem de olhar mesmo para o caso. Confirme o que se aplica à sua empresa na calculadora das regras da IA e leia IA e RGPD: o que uma PME pode e não pode fazer. Este artigo não é aconselhamento jurídico.
Mesmo com faturas e emails, há dados pessoais pelo meio (nomes, moradas, contactos). Use a API ou a versão empresarial do fornecedor, com o acordo de tratamento de dados assinado e o uso para treino desligado; explicamos as opções em retenção zero de dados na IA.
Onde se monta: n8n ou Make
Não precisa de programar. As duas ferramentas de automação que mais tratamos no site fazem isto com blocos:
- n8n: o nó Text Classifier faz a classificação e cria um ramo de saída por categoria. Para verificar faturas, o nó de extração lê os campos e uma condição simples decide se segue ou vai para revisão. O passo a passo está em automação com n8n, e a extração de faturas em faturas, contratos e formulários com IA.
- Make: um módulo de IA classifica, e um router (o bloco do Make que divide o fluxo em caminhos) com filtros envia cada categoria para o seu destino.
A diferença entre as duas, e o Zapier, está em n8n, Make ou Zapier: qual escolher. Para emails de clientes, o guia de IA no apoio ao cliente mostra o passo seguinte: preparar a resposta depois da triagem.
O que fazer esta semana
Escolha uma só pergunta de sim ou não que alguém na empresa responde dezenas de vezes por semana, por exemplo “este email é uma reclamação?”. Junte 100 exemplos reais do último mês, peça a quem faz esse trabalho que os classifique numa folha de cálculo e guarde a folha. É o material de teste de que vai precisar, qualquer que seja o modelo ou a ferramenta que escolher depois.
Preços e funcionalidades verificados a 1 de outubro de 2026. Valores convertidos para euros ao câmbio do BCE de 30 de setembro de 2026, sem IVA.
Fontes
- OpenAI: Structured Outputs (documentação)
- Anthropic: structured outputs (documentação)
- Google AI for Developers: structured output na API Gemini
- OpenAI: preços da API
- Anthropic: preços da API
- Google AI for Developers: preços da API Gemini
- OpenRouter: Jev 1.13 (TypeSafe)
- OpenRouter: Solar Decide (Upstage)
- OpenRouter: tutorial do Jev e da Decisions API
- OpenRouter: Jev ou modelo de linguagem, quando usar cada um
- n8n: nó Text Classifier
- EUR-Lex: Regulamento (UE) 2016/679, o RGPD
- Comissão Europeia: quadro regulamentar da IA
- BCE: taxas de câmbio de referência do euro
Escrevemos para quem gere empresas em Portugal. Cada preço tem fonte e data; quando algo muda, atualizamos o artigo.
Precisa de ajuda a implementar?
Trabalhamos com parceiros com experiência a pôr estas ferramentas a funcionar em PME portuguesas. Diga-nos o que quer montar e ligamos-lhe para perceber o que faz sentido, quanto custa e quanto tempo demora.
- Resposta em até 24 horas
- Primeira conversa sem custo nem compromisso
- Pode juntar um apoio do Estado ao projeto, se houver aviso aberto